tech n8n telegram ai support supabase groq pinecone slack template relay
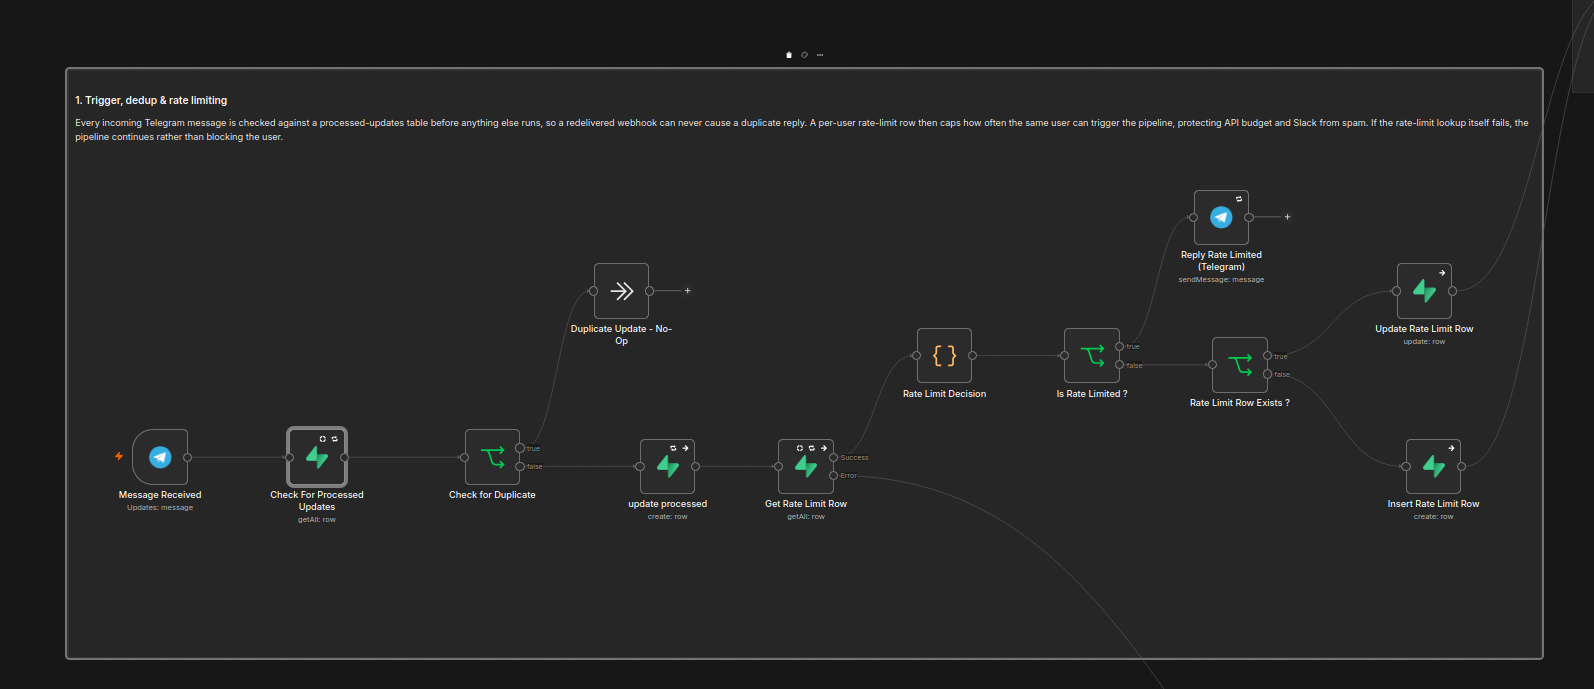
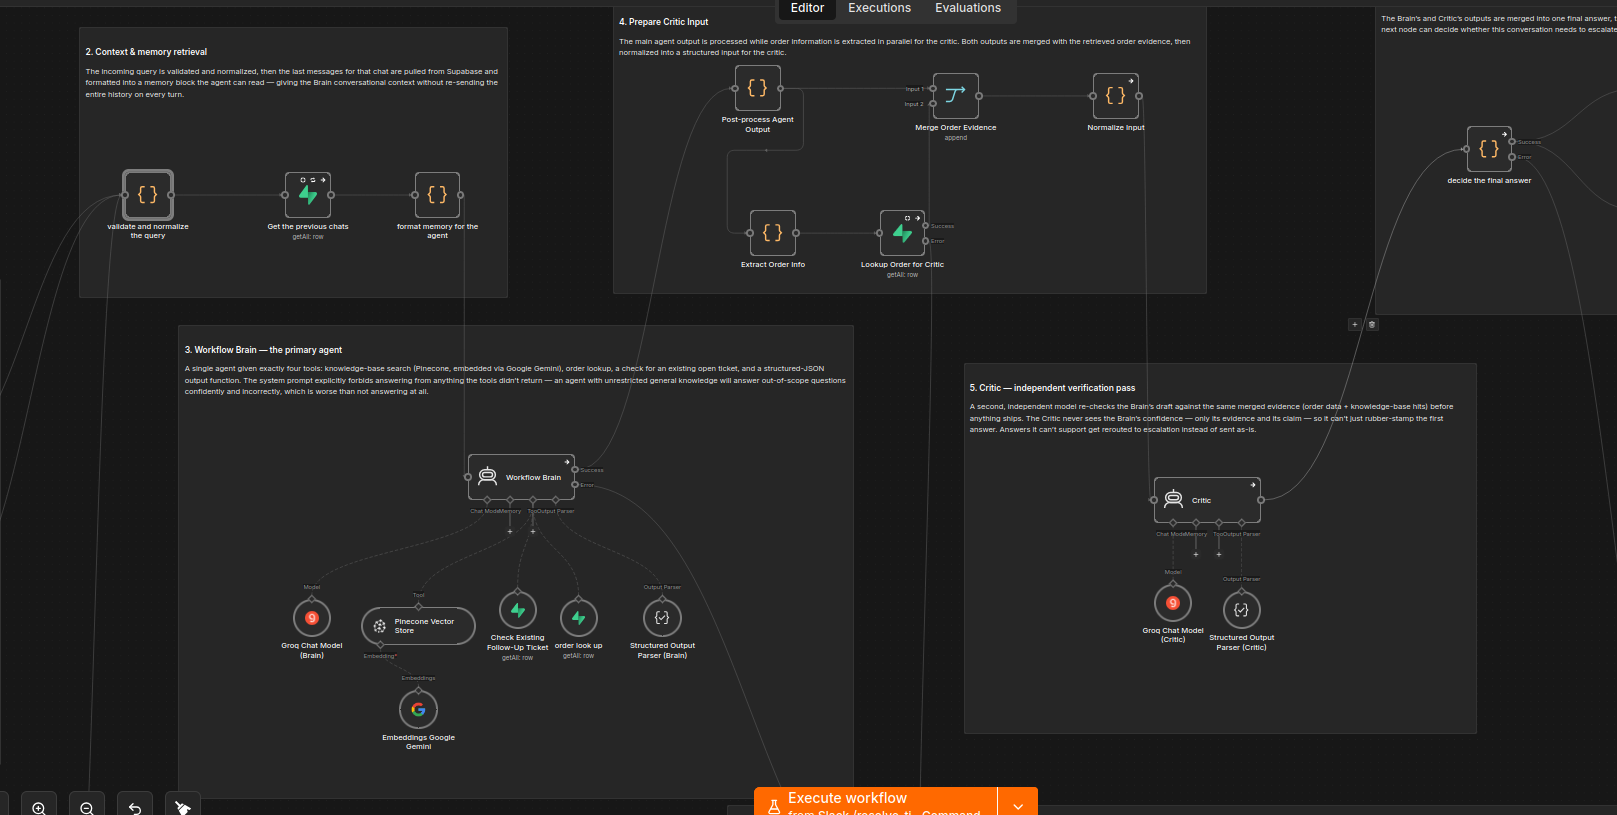
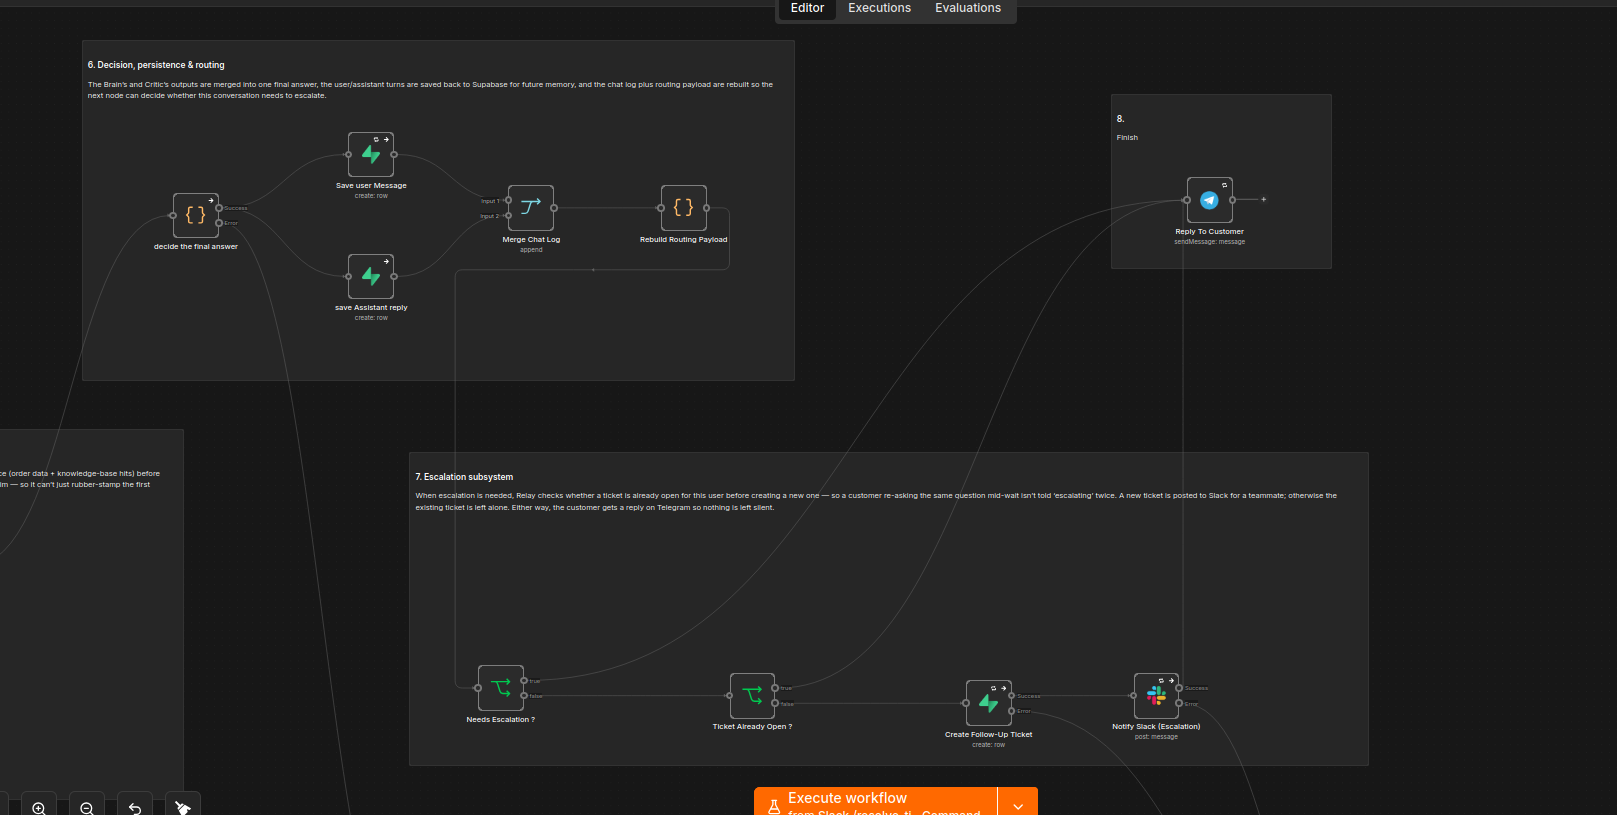
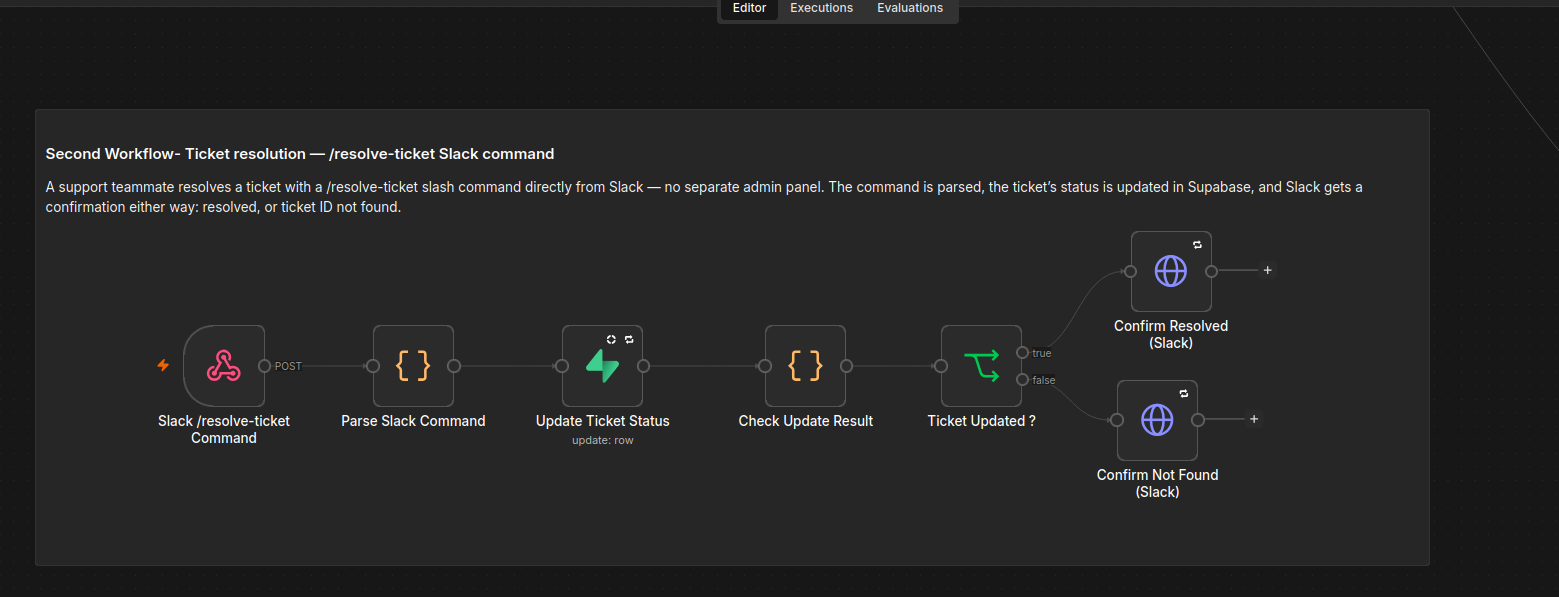
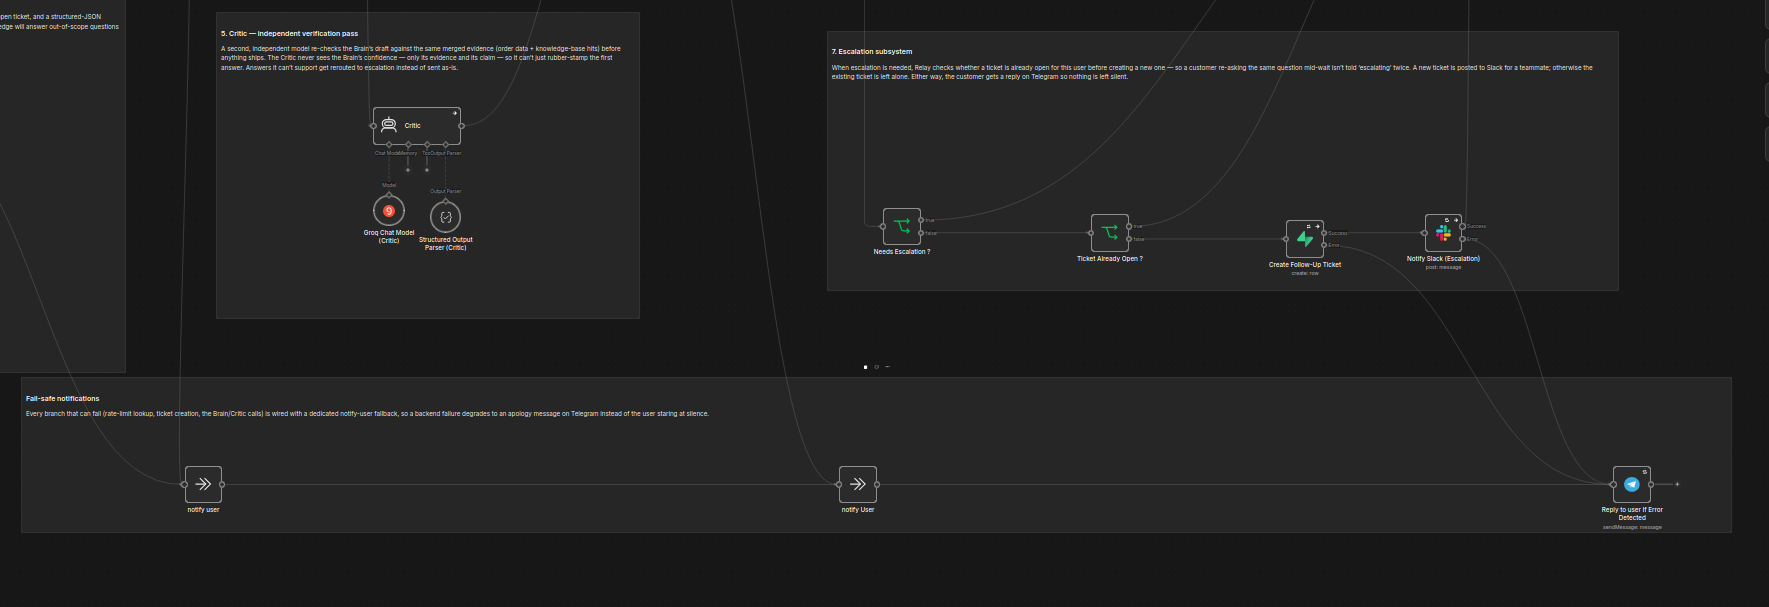
Table of contents
- Overview
- Kegunaan utama
- Analogi sederhana
- Alur per blok (canvas RELAY)
- Stack teknologi
- Bandingkan dengan Workflow help-dev (WhatsApp)
- Kalau nanti re-create — checklist
- Celah umum (multi-channel)
- Referensi
Overview
Workflow RELAY itu bot customer support di Telegram. Botnya jawab dari data asli (FAQ / knowledge base + data order di database), bukan tebak-tebakan. Kalau bingung atau jawabannya nggak aman, naik ke manusia lewat Slack, dan status tiketnya kecatat supaya loop-nya nutup.
| Item | Value |
|---|---|
| Nama template | RELAY — Route Telegram support |
| Author | Akshat (n8n template #19501) |
| Channel | Telegram (customer) |
| LLM | Groq (brain + critic) |
| State / data | Supabase (Postgres) |
| Knowledge | Pinecone + Google Gemini embeddings |
| Human loop | Slack (eskalasi + /resolve-ticket) |
| Posting asal | Reddit r/n8n — critic agent, fail-open rate limit |
Kegunaan utama
Satu kalimat: menggantikan balasan support manual yang repetitif, tapi tetap aman buat production — nggak dobel balas, nggak bisa di-spam, jawaban dicek lagi sebelum dikirim, dan kalau AI kewalahan ada eskalasi + tiket yang tim bisa resolve dari Slack.
Bukan “satu AI Agent node doang”. Ini sistem dengan guardrail di luar model.
Analogi sederhana
Bayangin toko online:
- Customer chat di Telegram: “Order #12345 mana?”
- Bot cari di FAQ (Pinecone) dan cek order live (Supabase).
- Bot nulis draft jawaban.
- “Critic” (agent kedua) baca draft: “Apakah ini cocok dengan data order? Nggak ngawur? Nggak kasar?”
- Kalau oke → balas customer + simpan chat buat ingat konteks lain kali.
- Kalau nggak oke / butuh manusia → bikin tiket, ping Slack, tetap balas customer (“sudah kami teruskan ke tim”).
- CS di Slack ketik
/resolve-ticket→ status di database jadi resolved → customer chat lagi nggak diperlakukan seperti permintaan baru yang polos.
Itu inti RELAY.
Alur per blok (canvas RELAY)
1. Trigger, dedup & rate limiting
Masalah: Telegram kadang kirim update yang sama dua kali kalau run n8n lambat → customer dapat dua balasan identik.
- Dedup: Setiap
update_iddicek di tabelprocessed_updates. Kalau sudah pernah diproses → stop, nggak lanjut pipeline. - Rate limit: Per chat, misalnya maks 2 pesan per 60 detik. Lewat → balas “slow down”, nggak masuk ke AI (hemat biaya & API).
- Fail-open: Kalau cek rate limit error (DB down, dll.), user tetap dilayani — nggak diblokir cuma karena infra rate limit rusak. Trade-off: lebih ramah user, sedikit lebih rentan spam kalau DB mati.
Layer infrastruktur, bukan “kepintaran” AI.
Telegram message
    ↓
Check processed_updates (Supabase)
    ↓ duplicate? → no-op
Mark update processed
    ↓
Rate limit row (Supabase) — fail-open kalau error
    ↓ limited? → reply rate limited
    ↓
Lanjut ke context + agent
2. Context & memory retrieval
Masalah: Satu pesan tanpa riwayat sering ambigu (“yang kemarin gimana?”).
- Normalisasi teks user.
- Ambil ~10 pesan terakhir chat itu dari Supabase (
chat_memory). - Format jadi history buat agent.
Pengganti / pelengkap Simple Memory di n8n — memory-nya persisten di DB, bukan cuma di RAM node memory.
3. Main brain (agent utama)
Peran: Draft jawaban + boleh panggil tool, tapi nggak boleh ngarang fakta di luar tool.
| Tool | Fungsi |
|---|---|
| Pinecone + embeddings | RAG: cari potongan dokumen/FAQ yang relevan |
| Order lookup (Supabase) | Data order live |
| Check open ticket | Cek apakah user sudah punya tiket follow-up terbuka |
| Escalate (konseptual) | Sinyal “butuh manusia” — biasanya lewat output terstruktur |
Output sering structured (JSON) biar node berikutnya bisa parse.
Domain-nya support umum + order + KB, bukan wizard form kanban step-by-step.
4. Prepare critic input
Peran: Kumpulin bukti buat reviewer.
- Ambil draft dari brain.
- Kalau draft menyebut order ID/email → fetch lagi record order dari DB.
- Merge jadi paket: pertanyaan user, draft, bukti order, cuplikan KB.
Critic nggak cuma baca “teks cantik” dari brain — ada evidence bundle.
5. Critic (agent kedua, job sempit)
Filosofi dari posting Reddit — ini kuncinya:
Critic dilarang menambah fakta baru, meski fakta itu “jelas benar”. Hanya boleh:
- Reject kalau jawaban kontradiksi record DB,
- Reject kalau off-topic padahal tool bisa jawab,
- Reject kalau rude.
Bukan “editor kreatif”, tapi quality gate / fact-checker.
Dua kali LLM = lebih lambat & lebih mahal. Masih masuk akal kalau model cloud kuat tool-calling; kalau model lokal lemah, perlu pola lain (prefetch + code gate).
6. Decision, persistence & routing
- Gabung output brain + critic → jawaban final (approve / revise / escalate).
- Simpan turn user + assistant ke
chat_memory. - Siapkan routing payload: kirim biasa ke Telegram, atau masuk jalur eskalasi.
7. Escalation subsystem
Masalah: Agent bilang “saya eskalasi” terus bikin 10 tiket untuk masalah yang sama.
- Cek: perlu eskalasi?
- Cek lagi: tiket untuk user/chat ini sudah open?
- Sudah → balas “ini sudah ditangani tim”, jangan duplicate ticket.
- Belum → insert
follow_up_tickets(pending) + notify Slack.
- Tetap balas di Telegram — customer nggak dibiarkan diam.
Agent nggak boleh invent escalation tanpa cek tiket open dulu.
8. Finish + workflow kedua (/resolve-ticket)
Workflow utama: balas customer.
Workflow terpisah (webhook Slack):
- CS:
/resolve-ticket <id> - Parse command → update status tiket di Supabase
- Slack dapat konfirmasi: resolved atau ID nggak ketemu
Loop nutup: eskalasi → human di Slack → status ke DB → brain check open ticket lagi saat user chat berikutnya.
Fail-safe (garis panjang di canvas)
Setiap cabang yang bisa error (Supabase, Groq, Pinecone) punya jalur ke notify user — customer dapat pesan “maaf, lagi gangguan”, bukan silence. Beda besar dengan workflow yang cuma “node error = execution merah, user nggak dapat apa-apa”.
Stack teknologi
| Komponen | Peran |
|---|---|
| Telegram | Channel chat customer |
| Supabase (Postgres) | Dedup, rate limit, memory, orders, tickets — single source of truth state |
| Pinecone + Gemini embeddings | Knowledge base vektor (RAG) |
| Groq | Brain + critic (LLM cepat) |
| Slack | Inbox tim + resolve command |
Bandingkan dengan Workflow help-dev (WhatsApp)
Workflow internal: Workflow help-dev (4q4EpeePiAdrB7W6) — WhatsApp + Ollama + MySQL bururu_dev.
| Aspek | RELAY (Akshat) | Help-dev WA |
|---|---|---|
| Tujuan | Support + FAQ + order + eskalasi | Form conversational buat tiket kanban |
| Memory | DB (chat_memory) | Simple Memory + prefetch SQL tiap pesan |
| Data | Supabase + Pinecone | MySQL (project, worker, tasks) |
| Quality | Agent + critic | Agent + Gabung balasan (list dari MySQL) |
| Commit aksi | Escalate / reply | Insert task hanya setelah “iya” (idealnya di-gate di workflow) |
| Human loop | Slack resolve | Belum (tiket langsung ke board) |
| Production hygiene | Dedup + rate limit | Belum (WA Meta + satu workflow) |
Pola yang sama dan worth ditiru:
- Prefetch data sebelum agent (Data tiket → Siapkan konteks).
- Jangan andalkan model untuk nulis list panjang (Gabung balasan).
- State di DB, bukan cuma memory node (RELAY jauh lebih kuat di sini).
- Gate aksi berbahaya (insert/simpan) di logic workflow, bukan cuma di prompt.
Pola RELAY yang belum wajib di Help-dev kecuali scale:
- Pinecone RAG (wizard tiket nggak butuh FAQ vektor).
- Critic agent (overkill kalau output mostly template + list dari SQL).
- Slack escalation (bisa nanti kalau WA cuma intake, human approve di web).
Kalau nanti re-create — checklist
- Tabel/state apa saja?
processed_updates,rate_limits,chat_memory,orders,follow_up_tickets— lihat setup di template n8n. - Brain boleh apa, nggak boleh apa? (tool-only facts, structured output).
- Critic input apa saja? (draft + DB evidence, bukan chat panjang tanpa bukti).
- Kapan escalate vs balas? + anti-duplicate ticket.
- Error path ke pesan user di setiap integrasi kritis.
- Workflow kedua buat
/resolve-ticket(webhook terpisah).
Versi WhatsApp + Ollama + MySQL bukan copy-paste: Telegram → WA, Groq → Ollama, Supabase → MySQL (atau Supabase cuma memory/dedup), Pinecone optional, Slack optional.
Versi mini vs full RELAY:
| Versi mini | Full RELAY |
|---|---|
| dedup + memory MySQL + satu agent + insert gated | + critic + Pinecone + Slack + fail-safe di semua cabang |
Celah umum (multi-channel)
Pertanyaan di Reddit: “adding more channels — where still falls short?”
Celah umum arsitektur kayak RELAY:
- Channel beda format (WA template, media, webhook Meta) — dedup/rate limit harus per channel.
- Memory & ticket harus key-nya universal (phone vs telegram_id vs email).
- Critic mahal/lambat di model lokal lemah — mungkin perlu rule-based gate (prefetch + Code node) buat sebagian step.
- RAG per produk/locale — Pinecone index & embedding harus maintained.
- Human loop cuma Slack — tim di WA/email butuh channel eskalasi yang sama secara data.
Referensi
| Sumber | URL |
|---|---|
| n8n template (RELAY) | https://n8n.io/workflows/19501-route-telegram-support-with-groq-pinecone-supabase-and-slack/ |
| Reddit — critic, fail-open, escalation | https://www.reddit.com/r/n8n/comments/1wkhlhv/built_a_support_bot_with_a_dedicated_critic_agent/ |
| Clone template lokal (awesome-n8n) | /home/asrofil/Project/reference/mcp/awesome-n8n-templates |
| Instance n8n internal | http://172.21.13.25:5678 — workflow help-dev terpisah |
Setup resmi template (ringkas):
- Telegram Bot credentials + webhook ke trigger workflow.
- Supabase + tabel:
processed_updates,rate_limits,chat_memory,orders,follow_up_tickets. - Groq API (brain + reviewer).
- Pinecone index sendiri + Gemini embeddings (ganti placeholder
company-latest). - Slack channel eskalasi + slash command POST ke webhook
/resolve-ticket.